DRBD Pacemaker-configuratie: Rocky Linux 9·STONITH·2-node HA
AI_Manager
DRBD Pacemaker: DRBD repliceert blokapparaten tussen twee servers, terwijl Pacemaker en Corosync bepalen welke node de Primary-rol krijgt en het bestandssysteem, het virtuele IP en de services beheert. Het simpelweg op beide nodes als Primary instellen van DRBD of het gelijktijdig mounten van XFS kan leiden tot datacorruptie; daarom moet het Active/Passive-principe en de regel van geforceerd enkelvoudig schrijven strikt worden nageleefd.
Oude CentOS 7.9-voorbeelden zijn verouderd vanwege het einde van de ondersteuning, het gebruik van de verouderde Master/Slave-terminologie en het ontbreken van fencing, en mogen niet zomaar worden toegepast in moderne productieomgevingen. Dit artikel beschrijft de ontwerpprincipes en verificatiestappen op basis van Rocky Linux 9, DRBD 9 en het huidige Promoted/Unpromoted-model van Pacemaker. Controleer altijd de pakketversies en ondersteunde combinaties in de documentatie van de distributie of LINBIT.
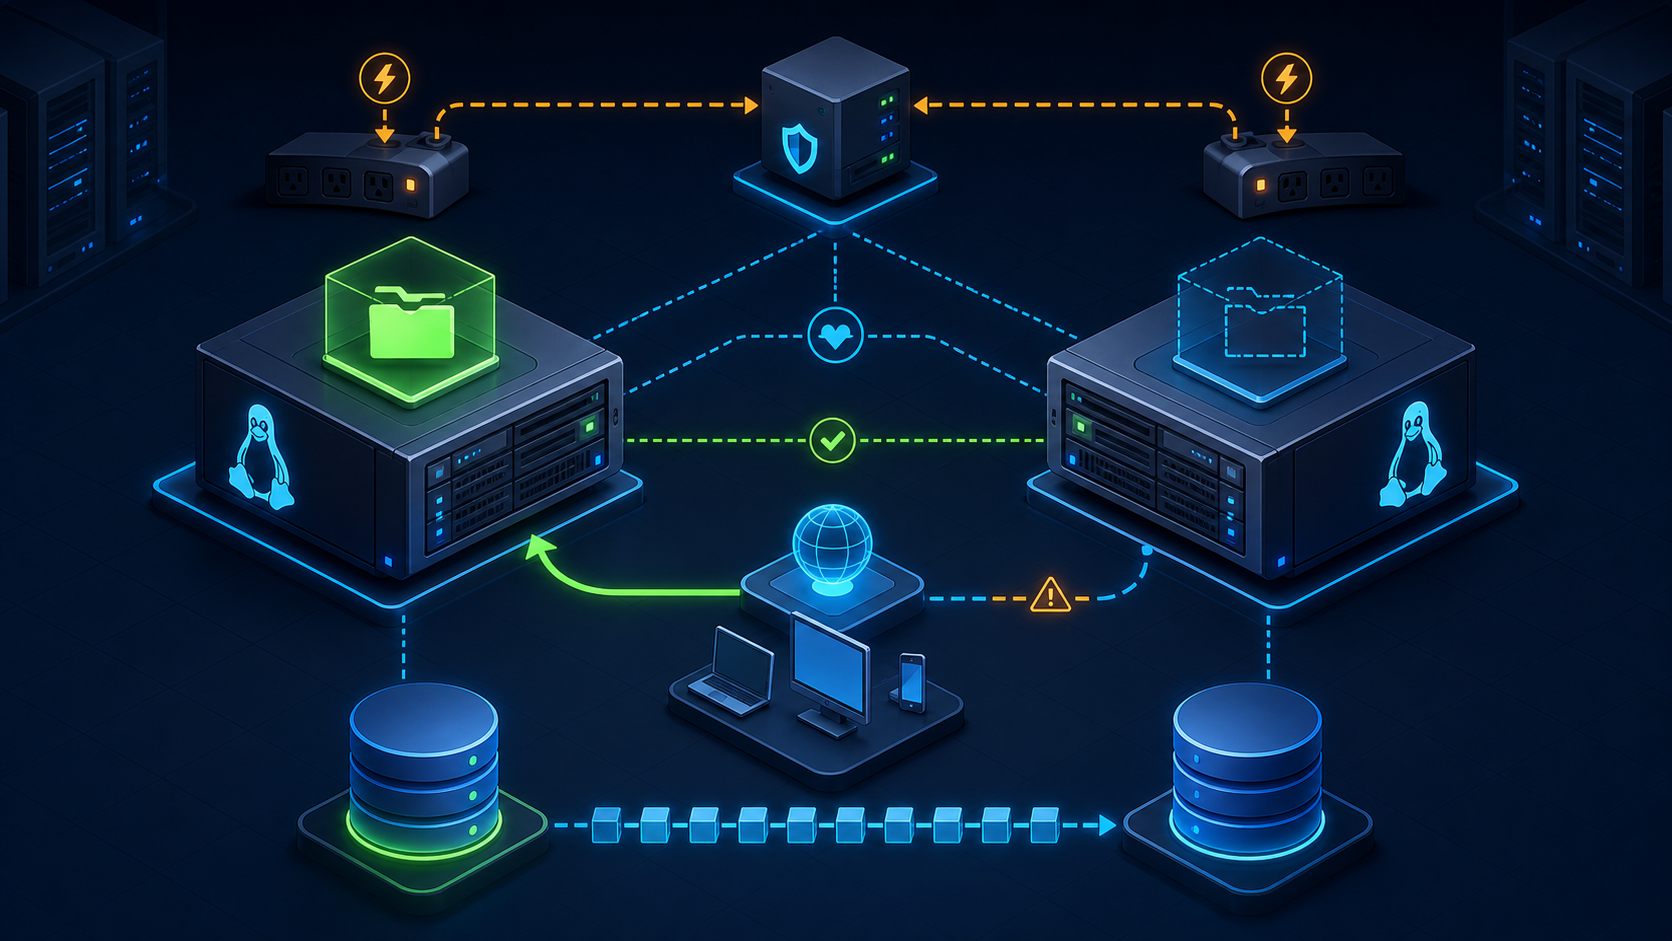
DRBD Pacemaker-architectuur en foutgrenzen
| Laag | Rol | Beschermingsmechanisme bij falen |
|---|---|---|
| DRBD 9 | Synchrone blokreplicatie | Protocol C, Single Primary, controle van replicatiestatus |
| Corosync | Node-lidmaatschap, messaging en quorum | Toegewezen of redundant netwerk, evaluatie van qdevice |
| Pacemaker | Resourceplaatsing, volgorde en herstel | Promoted-rol, colocation- en order-constraints |
| STONITH | Blokkeren van stroom of toegang tot niet-geïsoleerde nodes | Onafhankelijk beheer-netwerk, daadwerkelijke fence-tests |
| Bestandssysteem | XFS als enkele writer boven op DRBD | Alleen mounten op de gepromote node |
| VIP en services | Client-toegangspunt en applicaties | Starten na Filesystem en stoppen in omgekeerde volgorde |
| Back-up | Herstel na verwijdering, corruptie of ransomware | Testen van versiebeheerde back-ups en herstel los van DRBD |
Het uitschakelen van de STONITH-functionaliteit in Pacemaker is een onveilige operationele instelling. Als een node waarvan de communicatie is verbroken niet kan bewijzen dat deze daadwerkelijk is gestopt, kunnen beide nodes het eigendom van dezelfde gegevens claimen. Configureer en test fencing voordat u resources opstart.
Vereisten voor het opzetten van DRBD Pacemaker
- Bevestig de compatibiliteit van het besturingssysteem, de DRBD-kernelmodule en -utils, Pacemaker, Corosync, pcs en de resource agent op beide nodes.
- Controleer de forward en reverse DNS-resolutie van de hostnamen en de NTP-synchronisatie.
- Scheid de storingsdomeinen van het replicatienetwerk, het Corosync-communicatienetwerk, het servicenetwerk en het BMC/fencing-beheernetwerk zoveel mogelijk.
- Controleer de grootte en sectorinformatie van de backing devices aan beide kanten en verifieer dat er geen bestandssysteem- of LVM-handtekeningen op de partities staan.
- Bereid een toegewezen fence agent, BMC-account, qdevice of een derde beslissingspunt voor.
- Documenteer de RPO, RTO en de handmatige herstelprocedures bij datacorruptie, split-brain of site-storingen.
Voorafgaande controle van nodes en opslagapparaten
hostnamectl --static
timedatectl status
chronyc tracking
getent hosts ha1.example.com ha2.example.com

lsblk -o NAME,SIZE,TYPE,FSTYPE,MOUNTPOINTS,MODEL,SERIAL
sudo blkid /dev/vdb1
sudo wipefs --no-act /dev/vdb1
Het voorbeeld gebruikt /dev/vdb1, maar in een echte omgeving moeten WWID, multipath en LVM-lagen duidelijk worden geïdentificeerd. Controleer of apparaatnamen niet veranderen na een herstart en stop als er bestaande handtekeningen worden gevonden. De optie –no-act van wipefs voert alleen een query uit; het daadwerkelijke verwijderingscommando wordt in dit artikel niet geautomatiseerd.
Controle van pakketten en resource agents
sudo dnf repolist
sudo dnf --showduplicates list   drbd-utils kmod-drbd pacemaker corosync pcs resource-agents fence-agents-all

rpm -q drbd-utils pacemaker corosync pcs resource-agents
modinfo drbd | head
drbdadm --version
pcs --version

pcs resource standards
pcs resource providers ocf
pcs resource agents ocf:linbit
De namen van DRBD-pakketten en de manier waarop kmod wordt geleverd, verschillen per repository. Controleer de RHEL-compatibiliteit, Secure Boot-ondertekening, het kernel-updatebeleid en de ondersteunende partij, en gebruik alleen geverifieerde repositories. Maak geen resources aan voordat de ocf:linbit:drbd agent daadwerkelijk is geïnstalleerd.
Configuratie van DRBD Pacemaker-replicatieresources
DRBD Protocol C is geschikt voor synchrone replicatie omdat het pas een voltooiing teruggeeft nadat het schrijven naar de externe schijf is bevestigd, maar het garandeert niet automatisch de fsync van de applicatie en het opslagcachebeleid. De datapad- en schrijfbewaringskenmerken bij stroomuitval van beide nodes moeten afzonderlijk worden getest.
Genereren van een DRBD shared secret
umask 077
openssl rand -base64 32

# Bewaar de uitvoer in een goedgekeurde geheime opslagplaats en
# implementeer deze identiek in de DRBD-configuratie van beide knooppunten.
Voorbeeld van /etc/drbd.d/r0.res
resource r0 {
  protocol C;
  device /dev/drbd0;
  disk /dev/vdb1;
  meta-disk internal;

  net {
    cram-hmac-alg sha256;
    shared-secret "REPLACE_WITH_GENERATED_SECRET";
  }

  on ha1.example.com {
    node-id 0;
    address ipv4 10.10.10.11:7789;
  }

  on ha2.example.com {
    node-id 1;
    address ipv4 10.10.10.12:7789;
  }
}
Beperk de toegang tot configuratiebestanden tot 0600 zodat alleen root ze kan lezen en zorg dat geheimen niet in platte tekst in logs van configuratiebeheer terechtkomen. Ga niet verder zonder de REPLACE-tekenreeks te vervangen door een echt geheim. Sta in de firewall alleen TCP 7789 toe vanaf het adres van de replicatiepartner en schakel SELinux en firewalld niet uit.
Genereren van metadata en opstarten van apparaten
sudo chown root:root /etc/drbd.d/r0.res
sudo chmod 0600 /etc/drbd.d/r0.res
sudo drbdadm dump r0
sudo drbdadm create-md r0
sudo drbdadm up r0

sudo drbdadm status r0 --verbose
sudo cat /proc/drbd
create-md schrijft DRBD-metadata naar het backing device. Controleer de apparaatselectie en back-up opnieuw voordat u dit op beide nodes uitvoert. Voor het converteren van volumes met bestaande gegevens is een afzonderlijke migratieprocedure vereist.
Initiële synchronisatie en aanmaken van bestandssysteem
# Alleen op een nieuw, leeg volume: voer dit tijdens een goedgekeurd wijzigingsvenster uitsluitend op ha1 uit
sudo drbdadm primary --force r0
watch -n 2 sudo drbdadm status r0

# Maak pas een nieuw XFS-bestandssysteem aan nadat beide peers de status UpToDate hebben
sudo mkfs.xfs -L ha_data /dev/drbd0
sudo mkdir -p /srv/ha-data
sudo mount /dev/drbd0 /srv/ha-data
sudo touch /srv/ha-data/cluster-marker
sudo umount /srv/ha-data
sudo drbdadm secondary r0
mkfs.xfs vernietigt de bestaande inhoud. Voer dit niet uit op volumes die worden hergebruikt of als er gegevens zijn die aan een van beide kanten bewaard moeten blijven. Als u tijdens de initiële synchronisatie de bron en het doel verwisselt, kunnen de juiste gegevens worden overschreven door lege blokken; controleer daarom of het nieuwe, lege apparaten zijn en wacht tot de status UpToDate/UpToDate is.
DRBD Pacemaker-cluster en STONITH
pcs-authenticatie en aanmaken van het Corosync-cluster
# Stel het hacluster-wachtwoord interactief in op beide knooppunten
sudo passwd hacluster

# Uitvoeren op één knooppunt en wachtwoord invoeren bij de prompt
sudo pcs host auth ha1.example.com ha2.example.com -u hacluster
sudo pcs cluster setup ha-drbd ha1.example.com ha2.example.com --start
sudo pcs cluster enable --all

sudo pcs cluster status
sudo pcs quorum status
sudo corosync-cfgtool -s
Bij twee nodes kan bij een communicatieonderbreking niet worden bepaald welke kant nog actief is. Overweeg een ontwerp waarbij een Corosync qdevice als derde stem fungeert, maar houd er rekening mee dat een qdevice STONITH niet vervangt. Als u gebruikmaakt van de interne quorum/diskless tiebreaker van LINBIT DRBD, combineer dan niet zomaar Pacemaker-fencing met DRBD resource-level fencing, maar kies één consistent ontwerp dat aansluit bij de ondersteuningsdocumentatie.
Verkennen van de fence agent en uitvoering van tests
sudo pcs stonith list
sudo pcs stonith describe fence_ipmilan
sudo pcs stonith config
sudo pcs property config --all

# Valideren na het aanmaken met parameters voor de werkelijke BMC-, PDU- of cloud-fence-agent van de apparatuur
sudo pcs stonith config --full
sudo pcs stonith status
fence_ipmilan is slechts een voorbeeld. Gebruik de fence agent, pcmk_host_map, onafhankelijke beheeradressen en accounts met minimale rechten die geschikt zijn voor uw apparatuur en platform. Zet wachtwoorden niet in de opdrachtgeschiedenis en gebruik de veilige methoden voor het doorgeven van geheimen die door de agent worden ondersteund.
# Alleen uitvoeren na dubbele controle van de service-impact en doelknooppunten in het onderhoudsvenster
sudo pcs stonith fence ha2.example.com

sudo pcs status --full
sudo journalctl -u pacemaker -u corosync --since '-10 min'
Bij een fencing-test moet handmatig worden gecontroleerd of de stroom van de doel-node daadwerkelijk is uitgeschakeld of dat de toegang tot de opslag is geblokkeerd. Vertrouw niet alleen op het succesbericht van de opdracht om te bepalen of het veilig is. Start geen data-resources zolang er een mislukte STONITH-configuratie aanwezig is.
Gebruik de maintenance mode om automatisch opstarten te voorkomen terwijl u de volgende resources en beperkingen in een leeg cluster aanmaakt. Voer deze oefenopdrachten niet zomaar uit in een cluster waar al bestaande services draaien, aangezien dit de beheerstatus van alle resources beïnvloedt.
sudo pcs property set maintenance-mode=true
sudo pcs property config
DRBD Pacemaker promotable resource
DRBD-agent en Promoted-rol
sudo pcs resource create drbd_r0 ocf:linbit:drbd   drbd_resource=r0   op monitor interval=15s role=Promoted   op monitor interval=30s role=Unpromoted

sudo pcs resource promotable drbd_r0   promoted-max=1 promoted-node-max=1   clone-max=2 clone-node-max=1   notify=true

sudo pcs resource config drbd_r0
sudo pcs status --full
Pacemaker gebruikt tegenwoordig de termen Promoted/Unpromoted in plaats van Master/Slave. De instelling promoted-max=1 beperkt het aantal Primary-nodes tot maximaal één op een bepaald moment. Controleer de resourcenaam en de clone-naam zoals gegenereerd door de pcs-versie om deze correct te gebruiken in de volgende beperkingsopdrachten.
Filesystem, VIP en servicegroep
sudo pcs resource create fs_data ocf:heartbeat:Filesystem   device=/dev/drbd0 directory=/srv/ha-data fstype=xfs   op monitor interval=20s timeout=40s

sudo pcs resource create vip_app ocf:heartbeat:IPaddr2   ip=192.0.2.50 cidr_netmask=24   op monitor interval=20s

sudo pcs resource create app_service systemd:myapp   op monitor interval=20s timeout=40s

sudo pcs resource group add app_group fs_data vip_app app_service
Zorg ervoor dat de myapp-service niet automatisch buiten het cluster start door het systemd enable-beleid op beide nodes op te schonen. IP-adres, interface, Filesystem-agentopties en service-timeouts moeten worden aangepast aan de werkelijke omgeving. XFS is een single-writer bestandssysteem dat op slechts één node tegelijk wordt gemount en wordt hier niet uitgebreid naar een dual-primary voorbeeld.
Volgorde- en colocation-beperkingen
# Gebruik de daadwerkelijk aangemaakte promotable clone-naam na verificatie in pcs status/config
sudo pcs constraint order   promote drbd_r0-clone then start app_group

sudo pcs constraint colocation add   app_group with promoted drbd_r0-clone INFINITY

sudo pcs constraint config --full
sudo pcs status --full
De order-beperking zorgt ervoor dat de groep pas start nadat DRBD is gepromoveerd, en colocation plaatst de groep op die gepromoveerde node. Binnen de groep wordt gestart in de volgorde Filesystem→VIP→service en gestopt in omgekeerde volgorde. Controleer de help-functie van de geïnstalleerde pcs-versie en de gegenereerde CIB voor de namen van beperkingen en de syntaxis van rollen.
DRBD Pacemaker-status en gegevensverificatie
Nadat u de configuratie van resources, volgorde, colocation en fencing hebt gecontroleerd, schakelt u de maintenance mode van het nieuwe oefencluster uit om het beheer te starten.
sudo pcs constraint config --full
sudo pcs stonith status
sudo pcs property set maintenance-mode=false
sudo pcs status --full
Controle van de normale status
sudo pcs status --full
sudo crm_mon -1Arf
sudo pcs resource config
sudo pcs constraint config --full
sudo drbdadm status r0 --verbose

findmnt /srv/ha-data
ip -brief address | grep '192.0.2.50'
curl --fail --silent --show-error http://192.0.2.50/healthz| Controle | Normale criteria | Eerste controle bij afwijkingen |
|---|---|---|
| DRBD-rol | Eén node Promoted/Primary, één node Unpromoted/Secondary | Handmatige promote-sporen, beperkingen, agent-logs |
| Schijfstatus | Beide UpToDate | Replicatienetwerk, backing device, resync-voortgang |
| Bestandssysteem | Alleen gemount op de Promoted-node | Colocation, order en automatische systemd-mount |
| STONITH | Beide nodes kunnen de peer daadwerkelijk isoleren | BMC-voeding, rechten, beheernetwerk, agent-timeout |
| Quorum | Verwachte stemmen en qdevice-status normaal | Corosync-link, wait_for_all, derde stem |
| Service | VIP en reactie van health-endpoint | Bestandssysteem gereed, app-logs, firewall |
DRBD Pacemaker failover-test
Voordat u zomaar kabels loskoppelt, moet u de resourcebeperkingen en applicaties verifiëren door een normale standby-overgang uit te voeren. Test daarna, volgens een goedgekeurd testplan, afzonderlijk het falen van serviceprocessen, het afsluiten van nodes, het verbreken van de Corosync-link, het verbreken van het replicatienetwerk en BMC-storingen.
sudo pcs node standby ha1.example.com
watch -n 2 sudo pcs status --full

curl --fail --silent --show-error http://192.0.2.50/healthz
ssh ha2.example.com 'findmnt /srv/ha-data; sudo drbdadm status r0'

sudo pcs node unstandby ha1.example.com
sudo pcs status --full
Zodra Pacemaker de resources beheert, mag u de status niet meer handmatig wijzigen met drbdadm primary, mount of systemctl start. Handmatige acties zorgen voor een discrepantie tussen de verwachte status in de CIB en de werkelijke status. Gebruik voor onderhoud de procedures voor standby of maintenance mode en controleer na afloop de beheerstatus van alle resources.
DRBD Pacemaker split-brain-afhandeling
- Stop de service en het automatische herstel en isoleer de twee nodes fysiek om te voorkomen dat ze tegelijkertijd gegevens wegschrijven.
- Bewaar de DRBD-rol, de schijfstatus, de Pacemaker-, Corosync- en fence-logboeken, evenals het laatste normale back-uppunt.
- Bepaal in overleg met de applicatiebeheerders welke gegevens de bron van waarheid zijn op basis van transacties.
- Laat twee personen controleren of alleen de beschadigde node wordt verwijderd (discard), zoals gekozen in de officiële split-brain-procedure van LINBIT.
- Controleer na de hersynchronisatie het bestandssysteem, de gegevensintegriteit, de servicefunctionaliteit en de back-ups.
- Corrigeer de hoofdoorzaken van het replicatienetwerk, quorum, STONITH en beperkingen, en herhaal dezelfde fouttest.
Het discard-my-data-commando voor split-brain-herstel kan leiden tot het volledig verwijderen van gegevens aan één kant; daarom bevat dit artikel geen kopieerbare uitvoeringsvoorbeelden. Ga niet verder zonder de bron van waarheid te selecteren en een back-up te hebben, en volg de officiële documentatie en ondersteuningsprocedures van de DRBD 9-versie die u gebruikt.
Commando’s voor bewijsverzameling
sudo drbdadm status r0 --verbose
sudo drbdsetup status --statistics
sudo pcs status --full
sudo crm_mon -1Arf
sudo corosync-cfgtool -s
sudo pcs quorum status

sudo journalctl -u drbd -u pacemaker -u corosync   --since '-30 min' --no-pager
Checklist voor DRBD Pacemaker-beheer
- Verwijderde CentOS 7-voorbeelden en legde de ondersteunde combinaties van OS, DRBD en Pacemaker vast.
- Controleerde het backing-device via serial/WWID en voerde een dubbele controle uit vóór de destructieve initialisatie.
- Scheidde de foutdomeinen van het replicatienetwerk, Corosync, servicenetwerk en BMC-fencingnetwerk.
- Testte STONITH in de praktijk en schakelde stonith-enabled niet uit.
- DRBD is ingesteld op promoted-max=1 en XFS wordt alleen gemount op de Promoted-node.
- Valideerde de order- en colocation-beperkingen van de Filesystem-, VIP- en servicegroepen.
- Legde de verwachte resultaten en RTO vast voor standby-situaties, het afsluiten van nodes, linkonderbrekingen en het falen van fencing.
- Maakte een versiebeheerde back-up los van DRBD en voerde een herstel uit in een geïsoleerde omgeving.
Officiële documentatie en gerelateerde artikelen over DRBD Pacemaker
- LINBIT DRBD 9 officiële gebruikershandleiding
- Officiële beschrijving van de ocf:linbit:drbd resource agent
- RHEL 9 Pacemaker aan de slag en fencing-documentatie
- Officiële RHEL 9 cluster quorum-documentatie
- ClusterLabs Pacemaker Explained
- Keuzegids GlusterFS vs DRBD
- GlusterFS Replica 3 installatie- en herstelgids
Conclusie
DRBD Pacemaker: De kern van 2-node HA is niet het zo snel mogelijk herstarten van services, maar ervoor zorgen dat de vorige eigenaar definitief is geïsoleerd en dat de juiste gegevens slechts op één plek worden weggeschreven. Valideer Protocol C, de enkele Promoted-rol, een werkende STONITH, quorum-besluitvorming en de beperkingen voor Filesystem, VIP en services. Replicatie is geen back-up; pas na het voltooien van fouttests en afzonderlijke hersteltests is er sprake van een operationeel inzetbare configuratie voor hoge beschikbaarheid.