SQL 리텐션 분석: 코호트·월 경계·중복 이벤트를 검증하는 예제
AI Editter
가입자 100명 중 다음 달 방문자가 20명이면 리텐션은 20%라고 말할 수 있습니다. 하지만 SQL에서 가입하지 않은 방문자를 섞거나, 이벤트 수를 사용자 수로 세거나, 아직 끝나지 않은 달을 비교하면 같은 데이터에서도 다른 숫자가 나옵니다.
먼저 지표를 고정합니다. 이 예제의 분모는 서울 시간 기준 해당 월 가입자 전체, 분자는 가입 이후 해당 월에 활동한 고유 사용자입니다. 첫 구매 기준 코호트나 연속 방문 리텐션은 다른 정의이므로 같은 표에 섞지 않습니다.
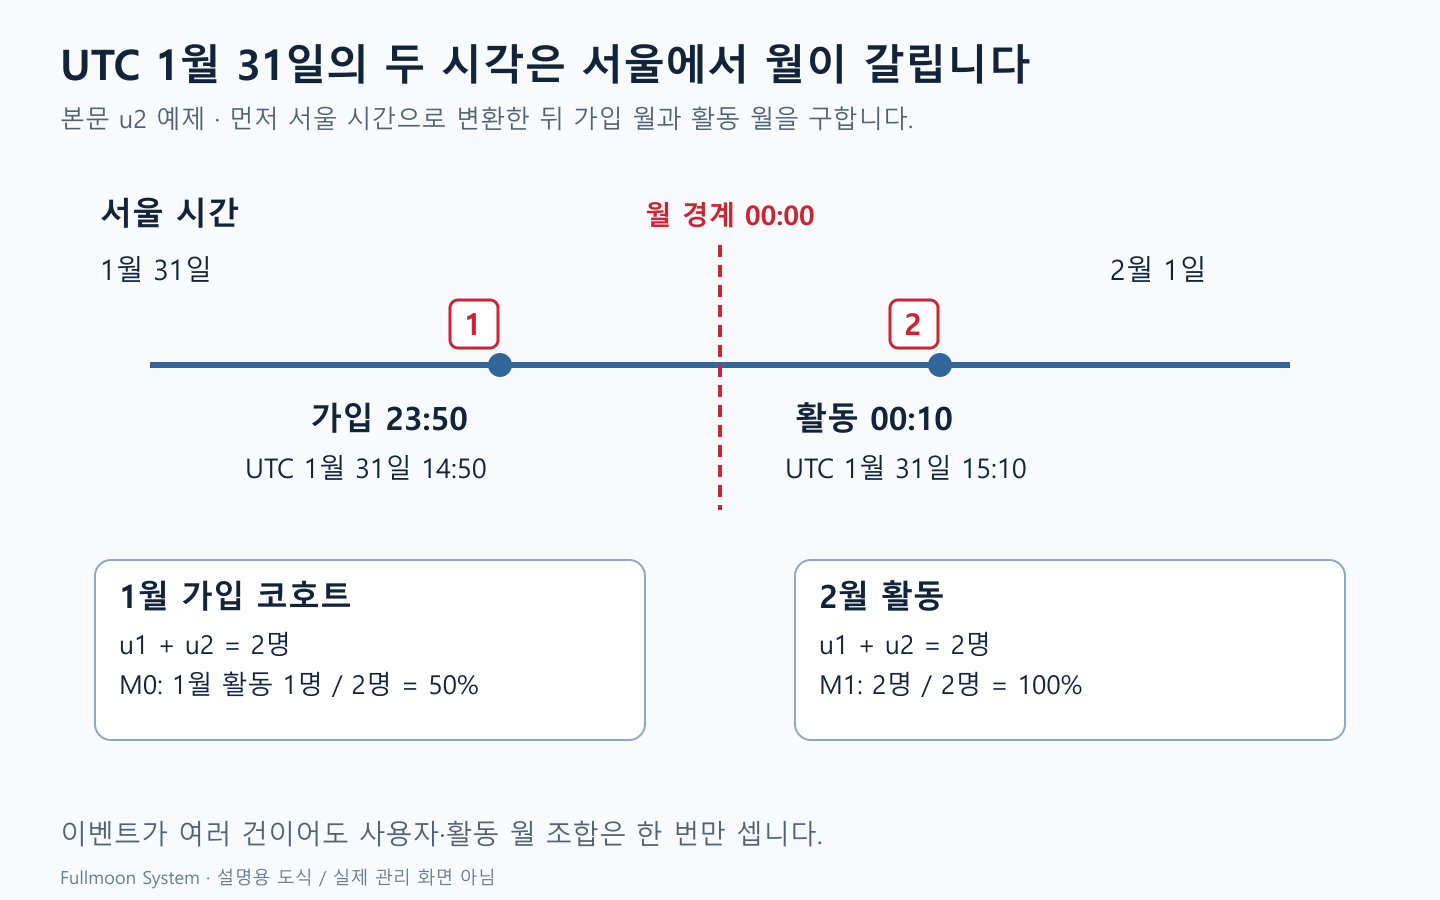
손으로 정답을 계산할 작은 자료
가입자는 u1·u2·u3입니다. u1과 u2는 1월 가입, u3은 2월 가입으로 정의합니다. u2의 가입 시각은 UTC 1월 31일 14:50, 서울 1월 31일 23:50입니다. 그 뒤 UTC 15:10의 활동은 서울에서는 2월 1일입니다.
| 사용자 | 가입 월 | 활동 월 |
|---|---|---|
| u1 | 1월 | 1월 두 번·2월 한 번 |
| u2 | 1월 | 2월 한 번 |
| u3 | 2월 | 없음 |
기대값은 1월 코호트의 M0가 1/2=50%, M1이 2/2=100%입니다. u3도 분모에 포함되므로 2월 코호트 M0는 0/1=0%입니다. 이 지표 정의에서는 M0가 반드시 100%일 필요가 없습니다.
PostgreSQL에서 재현하는 쿼리
다음 쿼리는 실제 테이블을 만들거나 수정하지 않습니다. VALUES로 입력을 만들며 2026년 3월 1일 서울 시간을 집계 마감으로 삼아 1·2월을 계산합니다. events는 이미 선택된 “활동” 이벤트만 담고 있다고 가정합니다.
WITH
params AS (
  SELECT TIMESTAMPTZ '2026-03-01 00:00:00+09' AS cutoff
),
users(user_id, signed_at) AS (
  VALUES
    ('u1', TIMESTAMPTZ '2026-01-10 00:00:00+09'),
    ('u2', TIMESTAMPTZ '2026-01-31 14:50:00+00'),
    ('u3', TIMESTAMPTZ '2026-02-10 00:00:00+09')
),
events(user_id, happened_at) AS (
  VALUES
    ('u1', TIMESTAMPTZ '2026-01-10 10:00:00+09'),
    ('u1', TIMESTAMPTZ '2026-01-10 10:01:00+09'),
    ('u1', TIMESTAMPTZ '2026-02-05 10:00:00+09'),
    ('u2', TIMESTAMPTZ '2026-01-31 15:10:00+00')
),
cohort_users AS (
  SELECT u.*,
    date_trunc('month', signed_at AT TIME ZONE 'Asia/Seoul')::date
      AS cohort_month
  FROM users u, params p
  WHERE signed_at < p.cutoff
),
cohort_sizes AS (
  SELECT cohort_month, count(*) AS cohort_size
  FROM cohort_users GROUP BY cohort_month
),
activity AS (
  SELECT DISTINCT u.user_id, u.cohort_month,
    date_trunc('month', e.happened_at AT TIME ZONE 'Asia/Seoul')::date
      AS activity_month
  FROM cohort_users u
  JOIN events e ON e.user_id = u.user_id
  CROSS JOIN params p
  WHERE e.happened_at >= u.signed_at
    AND e.happened_at < p.cutoff
),
grid AS (
  SELECT s.*, m.month_start::date AS activity_month
  FROM cohort_sizes s
  CROSS JOIN params p
  CROSS JOIN LATERAL generate_series(
    s.cohort_month::timestamp,
    date_trunc('month', p.cutoff AT TIME ZONE 'Asia/Seoul')
      - interval '1 month',
    interval '1 month'
  ) AS m(month_start)
)
SELECT g.cohort_month, g.activity_month, g.cohort_size,
  count(a.user_id) AS active_users,
  round(100.0 * count(a.user_id) / g.cohort_size, 2) AS retention_pct
FROM grid g
LEFT JOIN activity a
  ON a.cohort_month = g.cohort_month
 AND a.activity_month = g.activity_month
GROUP BY g.cohort_month, g.activity_month, g.cohort_size
ORDER BY g.cohort_month, g.activity_month;
결과가 틀릴 때 확인할 중간 집계
| 검사 | 이 예제의 기대값 |
|---|---|
| cohort_users | 3행 |
| 1월 cohort_size | 2 |
| 2월 cohort_size | 1 |
| activity | 사용자·활동 월 기준 3행 |
| 최종 결과 | 3행, 50.00·100.00·0.00 |
event가 중복돼도 같은 사용자의 같은 달은 한 번만 남습니다. 반대로 사용자 테이블에 동일 user_id가 두 행이면 분모가 커지므로 실무에서는 사용자 키의 유일성을 먼저 검사합니다. events에 사용자 ID가 없거나 가입 이력이 없는 행은 별도로 집계해 누락 이유를 조사합니다.
시간대와 관측 기간이 만드는 착시
UTC 월로 먼저 묶고 나중에 표 제목만 서울 시간으로 바꾸면 u2의 활동 월이 틀립니다. 시간대 변환 뒤 월 경계를 계산합니다. timestamp without time zone 컬럼이라면 저장된 값의 시간대 의미를 확인하고 변환식을 달리해야 합니다. PostgreSQL 날짜·시간 함수에서 타입별 동작을 확인할 수 있습니다.
3월 10일에 3월을 1·2월 전체와 비교하면 관측 기간이 다릅니다. 위 예제는 cutoff가 월 시작이라는 전제입니다. 임의 날짜를 넣을 수 있게 바꾸려면 마지막 완결 월과 현재 월 진행값을 분리합니다. 아직 도달하지 않은 M2를 0%로 채우지 않습니다.
운영 데이터로 확장할 때
활동 이벤트의 정의, 테스트 계정 제외, 탈퇴 사용자 처리, 지연 수집 데이터의 재집계 범위를 지표 문서에 남깁니다. 이벤트 수가 크면 사용자·월 집계 테이블을 만들 수 있지만 원본과 일정 구간을 대조하는 검사가 필요합니다.
최종 리텐션 표만 맞추기보다 코호트 인원, 고유 활동 사용자, 시간대 경계의 대표 사용자를 함께 확인하면 “왜 숫자가 달라졌는지” 설명할 수 있습니다. 같은 SQL을 매달 실행하는 것보다 같은 정의로 계산했는지가 더 중요한 검증입니다.