Linux-kernelarchitectuur: scheduler, geheugen, VFS, opstarten en foutdiagnose
AI_Manager
Linux-kernelarchitectuur: de kernlaag van het besturingssysteem die ervoor zorgt dat applicaties veilig CPU, geheugen, schijf en netwerk delen. Processen roepen kernel-functies niet direct aan, maar vragen diensten aan via de systeemaanroep-ABI, waarna de kernel de rechten en de status van de bronnen controleert voordat hardwaretaken worden uitgevoerd.
Dit artikel beperkt zich niet tot het opsommen van de classificatie als monolithische kernel. We volgen de opdrachten die op echte servers kunnen worden waargenomen om de onderlinge verbanden tussen scheduling, virtueel geheugen, VFS, opstarten, modules en panics te verifiëren, en leggen de diagnoseprincipes uit om geen ongegronde sysctl-aanbevolen waarden toe te passen.
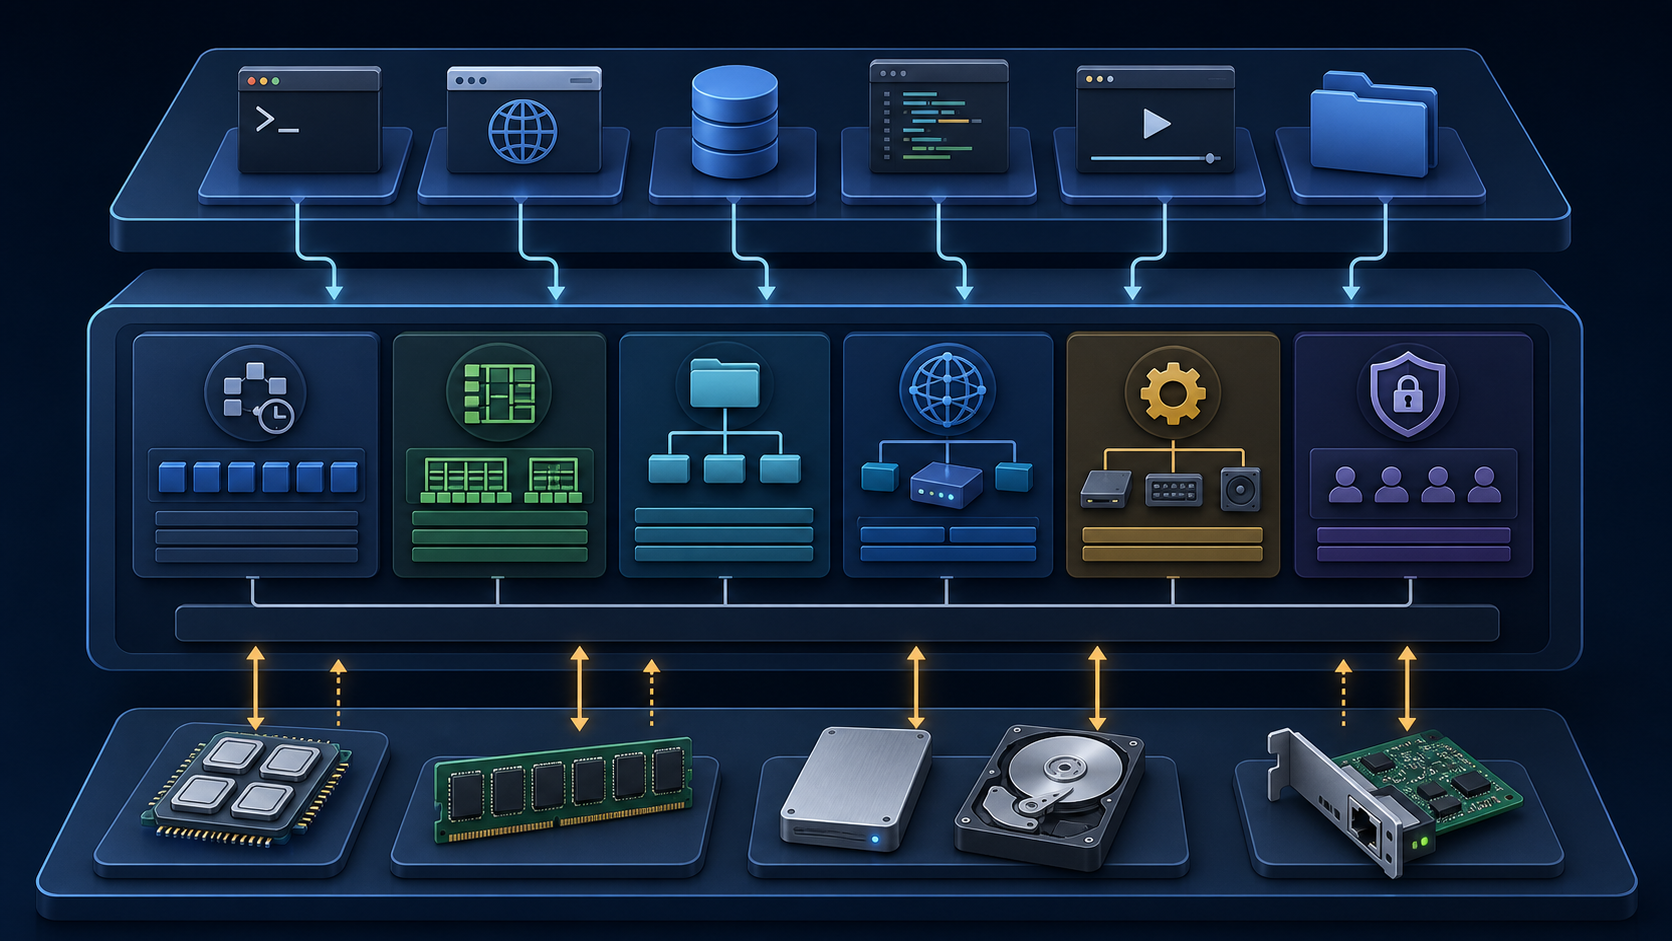
Linux-kernelarchitectuur in één oogopslag
Linux is een monolithische kernel die de scheduler, geheugenbeheerder, VFS, netwerkstack en de meeste stuurprogramma’s, waar prestaties cruciaal zijn, in de kernel-adresruimte uitvoert. Het ondersteunt echter laadbare kernelmodules om functies tijdens runtime toe te voegen of te verwijderen. De gebruikersruimte en kernelruimte worden gescheiden door CPU-rechtenniveaus en paginatabelbeveiliging.
| Laag | Representatieve configuratie | Hoe fouten zichtbaar worden |
|---|---|---|
| Gebruikersruimte | Shell, webserver, database, libc | Procesbeëindiging, vertraging, foutcodes |
| Systeemaanroepgrens | openat, read, write, mmap, clone | errno zoals EACCES, ENOMEM, EIO |
| Kernelruimte | Scheduler, MM, VFS, netwerk, LSM, stuurprogramma’s | Waarschuwingen, Oops, panics, bronnenstress |
| Hardware | CPU, RAM, blokapparaten, NIC | Machine check, I/O-fouten, interruptafwijkingen |
Huidige kernel en uitvoeringsomgeving controleren
uname -a
cat /etc/os-release
cat /proc/cmdline
systemd-detect-virt
cat /proc/sys/kernel/tainted
Als de laatste waarde niet 0 is, kan de kernel in een ‘tainted’-status verkeren door het laden van propriëtaire modules, het geforceerd verwijderen van modules, hardwarefouten, enzovoort. Trek geen conclusies op basis van het getal alleen, maar controleer de officiële uitleg van de taint-bits samen met de kernellogboeken.
Linux-kernelarchitectuur: kernsubsystemen
| Subsysteem | Nauwkeurige rol | Representatief observatiepunt |
|---|---|---|
| Scheduler | Beslist op welke CPU en wanneer uitvoerbare taken worden uitgevoerd | ps, schedstat, perf sched |
| Geheugenbeheer | Virtuele adressen, page faults, page cache, reclaim, en NUMA-beleidsbeheer | /proc/meminfo, vmstat |
| VFS | Biedt een gemeenschappelijke bestands-API en objectmodel voor verschillende bestandssystemen | findmnt, stat, /proc/filesystems |
| Netwerk | Verwerkt alles van sockets tot TCP/IP, routing, Netfilter en apparaatwachtrijen | ss, ip, nstat |
| Beveiliging | Toegangscontrole via DAC, capabilities, LSM, seccomp, enzovoort | id, getcap, ausearch |
| Drivers | Detecteert bussen en apparaten en koppelt deze aan gemeenschappelijke kernelinterfaces | lspci -k, lsmod, modinfo |
Linux-kernelstructuur: Systeem-call-grenzen
Applicaties gebruiken meestal libc-wrappers, maar libc is geen verplicht pad. Het is ook mogelijk om direct gebruik te maken van architectuurspecifieke systeem-call-instructies en aanroepconventies. De kernel controleert het systeem-call-nummer, de argumenten en de rechten, en geeft deze door aan de interne implementatie. Daarom is de uitspraak ‘glibc verwerkt systeem-calls’ onjuist; de correcte formulering is ‘glibc biedt vaak handige wrappers’.
Het pad voor het openen van bestanden controleren met strace
strace -f -e trace=openat,read,write,close cat /etc/hostname

# Alleen overzichtstatistieken controleren
strace -c cat /etc/hostname
In moderne glibc-omgevingen kan het openen van bestanden verschijnen als de openat()-familie in plaats van open(). Ga er niet vanuit dat de naam van de gebruikersfunctie altijd overeenkomt met de naam van de daadwerkelijke systeem-call.
Linux-kernelstructuur: CFS- en EEVDF-schedulers
De algemene taakplanning van Linux is preemptief. Het is onjuist om CFS te omschrijven als een ‘niet-preemptieve scheduler’. Bovendien is de algemene planningslogica vanaf kernel 6.6 begonnen met de overstap van het virtuele uitvoeringstijdmodel van CFS naar EEVDF. Omdat distributies backports kunnen bevatten, moet u niet alleen op de naam afgaan, maar de werkelijke kernelversie en de documentatie van de leverancier raadplegen.
uname -r
ps -eo pid,tid,psr,cls,pri,ni,stat,comm --sort=-pri | head -n 20
chrt -p $$
cat /proc/$$/sched | head -n 30
Let op: Meng de uitleg van CFS/EEVDF voor algemene taken niet met real-time beleid zoals SCHED_FIFO, SCHED_RR of het deadline-beleid. Het onjuist instellen van real-time prioriteiten kan leiden tot het uithongeren van beheer-shells en essentiële daemons; wijzig deze daarom niet zomaar op productieservers.
Linux-kernelstructuur: Virtueel geheugen en page cache
Virtuele adressen die door processen worden gezien, worden via de MMU en paginatabellen toegewezen aan fysiek geheugen of bestanden. Anoniem geheugen, bestandsmapping, page cache, slab, reclaim en swap beïnvloeden elkaar. Beoordeel geheugentekorten niet alleen op basis van de free-kolom in free, maar kijk ook naar available, swap, page fault, reclaim en PSI.
free -h
grep -E 'MemAvailable|Cached|Swap|Slab|SReclaimable' /proc/meminfo
vmstat 1 10
cat /proc/pressure/memory
ps -eo pid,comm,rss,vsz,%mem --sort=-rss | head -n 20
Geheugenruimte van processen controleren
PID=1234
pmap -x "$PID" | tail -n 20
cat "/proc/$PID/status" | grep -E 'VmRSS|VmSwap|Threads'
cat "/proc/$PID/smaps_rollup"
VmRSS bevat gedeelde pagina’s, waardoor de som van de waarden per proces hoger kan uitvallen dan het werkelijke fysieke geheugen. Gebruik smaps_rollup als u PSS nodig heeft om de gedeelde kosten te verdelen.
Linux-kernelstructuur: VFS en bestands-I/O
VFS biedt een gemeenschappelijke interface bovenop implementaties zoals ext4, XFS, Btrfs en NFS. Een pathname wordt via de dentry cache vertaald naar een inode, en een geopend bestand verwijst naar een file-object in de kernel vanuit de file descriptor-tabel van het proces. Dit is ook de reden waarom blokken niet worden vrijgegeven als een proces een verwijderd bestand open blijft houden: de referentierelatie blijft bestaan.
cat /proc/filesystems
findmnt -o TARGET,SOURCE,FSTYPE,OPTIONS
stat /var/log/messages
sudo lsof +L1
cat /proc/sys/fs/file-nr
Fouten in schijfruimte moeten worden onderzocht door onderscheid te maken tussen blokken, inodes en geopende verwijderde bestanden. Raadpleeg voor de gedetailleerde volgorde de No space left on device diagnosegids.
Linux-kernelstructuur: Opstarten en initramfs
Een typisch UEFI-systeem start op in de volgorde: firmware, bootloader, kernel en initramfs, het werkelijke root-bestandssysteem en PID 1. Initramfs wordt meestal als een gecomprimeerd cpio-archief doorgegeven om een initiële gebruikersruimte te bieden, die de benodigde modules en tools voor opslag, encryptie, LVM en RAID voorbereidt voordat wordt overgeschakeld naar de werkelijke root.
- De firmware selecteert een opstartitem en voert de bootloader of EFI-stub uit.
- De kernel configureert CPU, geheugen, interrupts en initiële drivers.
- De initiële gebruikersruimte van initramfs bereidt het werkelijke root-apparaat voor.
- Na switch_root start PID 1 van de werkelijke root de services en de inlogomgeving.
cat /proc/cmdline
systemd-analyze time
systemd-analyze critical-chain
journalctl -b -k -p warning

# Huidige inhoud van initramfs controleren op RHEL/Rocky-systemen
lsinitrd "/boot/initramfs-$(uname -r).img" | less
Het opnieuw genereren van initramfs of het wijzigen van GRUB kan leiden tot een systeem dat niet meer opstart. Zorg bij een externe server eerst voor consoletoegang, een oudere kernel en een opstartbare back-up- en herstelprocedure voordat u wijzigingen doorvoert volgens de documentatie van de distributie.
Diagnose van kernelmodules en stuurprogramma’s
Omdat modules met hoge privileges binnen de kernel worden uitgevoerd, verschilt de impact van een fout van die van een gebruikersprogramma. Als een apparaat niet zichtbaar is, controleer dan eerst het apparaat, het gekoppelde stuurprogramma, de modulehandtekening en de kernellogboeken in plaats van lukraak modules te verwijderen of opnieuw te laden.
lspci -nnk
lsmod | head
modinfo <module_name>
journalctl -k -b | grep -Ei 'firmware|module|driver|taint|error'
cat /proc/sys/kernel/tainted
modprobe -r kan opslag- en netwerkstuurprogramma’s die in gebruik zijn loskoppelen. Voer dit in productieomgevingen niet uit zonder de afhankelijkheden en de reikwijdte van de impact te controleren, en zonder te beschikken over een onderhoudsvenster en consoletoegang.
Linux-kernelstructuur: Diagnose van kernelpanics
Een Kernel Oops kan worden gelogd waarna de uitvoering doorgaat, maar de betrouwbaarheid van het systeem kan al zijn aangetast. Een Kernel Panic is een toestand waarin de kernel heeft vastgesteld dat normale uitvoering niet kan worden voortgezet; afhankelijk van de configuratie kan het systeem stoppen, na een bepaalde tijd herstarten of overschakelen naar een capture-kernel voor kdump. Ga er niet zomaar vanuit dat dit altijd een ‘shutdown ter bescherming’ is.
journalctl -k -b -1 -p warning..alert
last -x | head -n 20
sudo kdumpctl status
sysctl kernel.panic kernel.panic_on_oops
ls -lh /var/crash
Volgorde voor het onderzoeken van een panic
- Controleer het tijdstip van recente wijzigingen aan de kernel, stuurprogramma’s, firmware of hardware.
- Bewaar het volledige panic-scherm van de console of het beheerapparaat op afstand, inclusief de initiële foutmelding.
- Als kdump was voorbereid, verkrijg dan de vmcore en de debug-symbolen van dezelfde build.
- Stel vast of het probleem een regressie of een hardwarefout is door te kijken of het probleem zich ook voordoet bij het opstarten van een eerdere kernel.
- Voer op productieservers geen opzettelijke panic-triggers uit.
sysctl: meten, hypothese, terugdraaien
sysctl --system en sysctl -p passen instellingen direct toe op de kernel. Voer deze niet uit als syntaxiscontrole of als alleen-lezen diagnosecommando. Vervang de onderstaande bestandspaden door bestaande lokale configuratiebestanden en bereid, indien toepassing nodig is, tijdens een wijzigingsvenster de oorspronkelijke waarden en herstelcommando’s voor.
Er bestaat geen universele aanbevolen sysctl-waarde die voor alle webservers werkt. Bottlenecks variëren afhankelijk van de kernelversie, het geheugen, het verbindingspatroon, de applicatiewachtrij en containerbeperkingen. Vooral het zonder onderbouwing tegelijkertijd wijzigen van tcp_tw_reuse, poortbereiken, backlog en swappiness vertroebelt alleen maar de oorzaak van het probleem.
# 1. Lees de huidige waarde en gerelateerde metrieken.
sysctl vm.swappiness net.core.somaxconn net.ipv4.ip_local_port_range
ss -s
vmstat 1 10

# 2. Lees het configuratiebestand zonder het te wijzigen. Pas geen waarden toe.
sudo find /etc/sysctl.d /run/sysctl.d /usr/local/lib/sysctl.d /usr/lib/sysctl.d \
  -maxdepth 1 -type f -name '*.conf' -print 2>/dev/null
sudo cat /etc/sysctl.conf

# 3. Geef het te controleren bestand op en vergelijk de inhoud met de huidige kernelwaarden.
sudo cat /etc/sysctl.d/99-local.conf
sysctl vm.swappiness net.core.somaxconn net.ipv4.ip_local_port_range
Het bovenstaande commando is geen aanbeveling voor specifieke waarden, maar een raamwerk om de situatie voor en na de wijziging te observeren. Pas wijzigingen in productie één voor één toe en leg de succescriteria vast, zoals p95/p99-latentie, foutpercentages, hertransmissies en geheugendruk, evenals de waarden om direct terug te draaien.
Linux-kernelstructuur: Diagnose in 10 minuten
# 1. Versie, opstarten, taint
uname -r
uptime
cat /proc/sys/kernel/tainted

# 2. CPU-, geheugen- en I/O-druk
vmstat 1 10
cat /proc/pressure/{cpu,memory,io}

# 3. Recente kernelwaarschuwingen en gefaalde eenheden
journalctl -k -b -p warning..alert
systemctl --failed

# 4. Bestandssysteem en geopende verwijderde bestanden
df -hT
df -i
sudo lsof +L1
Diagnose is niet ‘eerst de tuning-waarden aanpassen’. Breng de tijdlijn in kaart, bepaal welke bron verzadigd is, controleer of de kernelwaarschuwing of de applicatiefout als eerste optrad en stel daarna een reproduceerbare hypothese op.
Correctie van veelvoorkomende misvattingen
| Veelgemaakte foutieve uitdrukkingen | Correcte uitleg |
|---|---|
| CFS is een niet-preemptieve scheduler | Algemene Linux-scheduling is preemptief en vanaf versie 6.6 is de overstap naar EEVDF ingezet. |
| Systeemoproepen worden afgehandeld door glibc | libc biedt meestal wrappers, terwijl de daadwerkelijke overgang van privileges en verwerking door de kernel wordt uitgevoerd. |
| Als er weinig vrij geheugen is, is er een tekort | Bekijk ‘available’, ‘reclaim’, ‘swap’, PSI en workload-statistieken in samenhang. |
| Een panic betekent altijd een onmiddellijke afsluiting | Afhankelijk van de ‘panic timeout’ en kdump-configuratie varieert het gedrag tussen stoppen, herstarten of het maken van een dump. |
| Aanbevolen sysctl-waarden zijn voor elke server gelijk | Deze moeten worden gemeten en één voor één worden gevalideerd op basis van de kernel, hardware en het verkeer. |
Officiële documentatie en verdere studie
- Documentatie over de Linux EEVDF-scheduler
- Documentatie over Linux-geheugenbeheer
- Overzicht van Linux VFS
- Documentatie over Linux /proc/sys/kernel
- Linux kdump-documentatie
- Gids voor isolatie van Python-gebruikersruimte
Samenvatting
Het begrijpen van de Linux-kernelstructuur betekent niet dat je termen uit je hoofd leert, maar dat je het vermogen hebt om symptomen in de gebruikersruimte te koppelen aan systeemoproepen, de scheduler, het geheugen, VFS en drivers. Begin met het bewaren van de huidige versie en logs, beperk de bottleneck-laag tot observatiestatistieken en valideer wijzigingen één voor één met een rollback-plan.