GlusterFS vs DRBD: Keuzehandleiding voor replicatie-eenheid, consistentie en HA
AI_Manager
GlusterFS vs DRBD: Beide technologieën repliceren gegevens via het netwerk, maar ze zijn geen vervanging voor elkaar. GlusterFS is een gedistribueerd bestandssysteem dat een bestandsnaamruimte biedt over meerdere bricks, terwijl DRBD blokapparaten repliceert onder het bestandssysteem. Als u niet eerst bepaalt welk type toegang uw applicatie nodig heeft, kiest u het verkeerde product.
Dit artikel vereenvoudigt de keuze niet tot ‘GlusterFS voor bestandsservers, DRBD voor databases’. We vergelijken het moment van schrijfvoltooiing, gelijktijdige aankoppeling (mounts), netwerkpartities, quorum, fencing, heal en de verantwoordelijkheid voor failover, en bieden daarnaast opdrachten voor statuscontroles en een selectiechecklist.
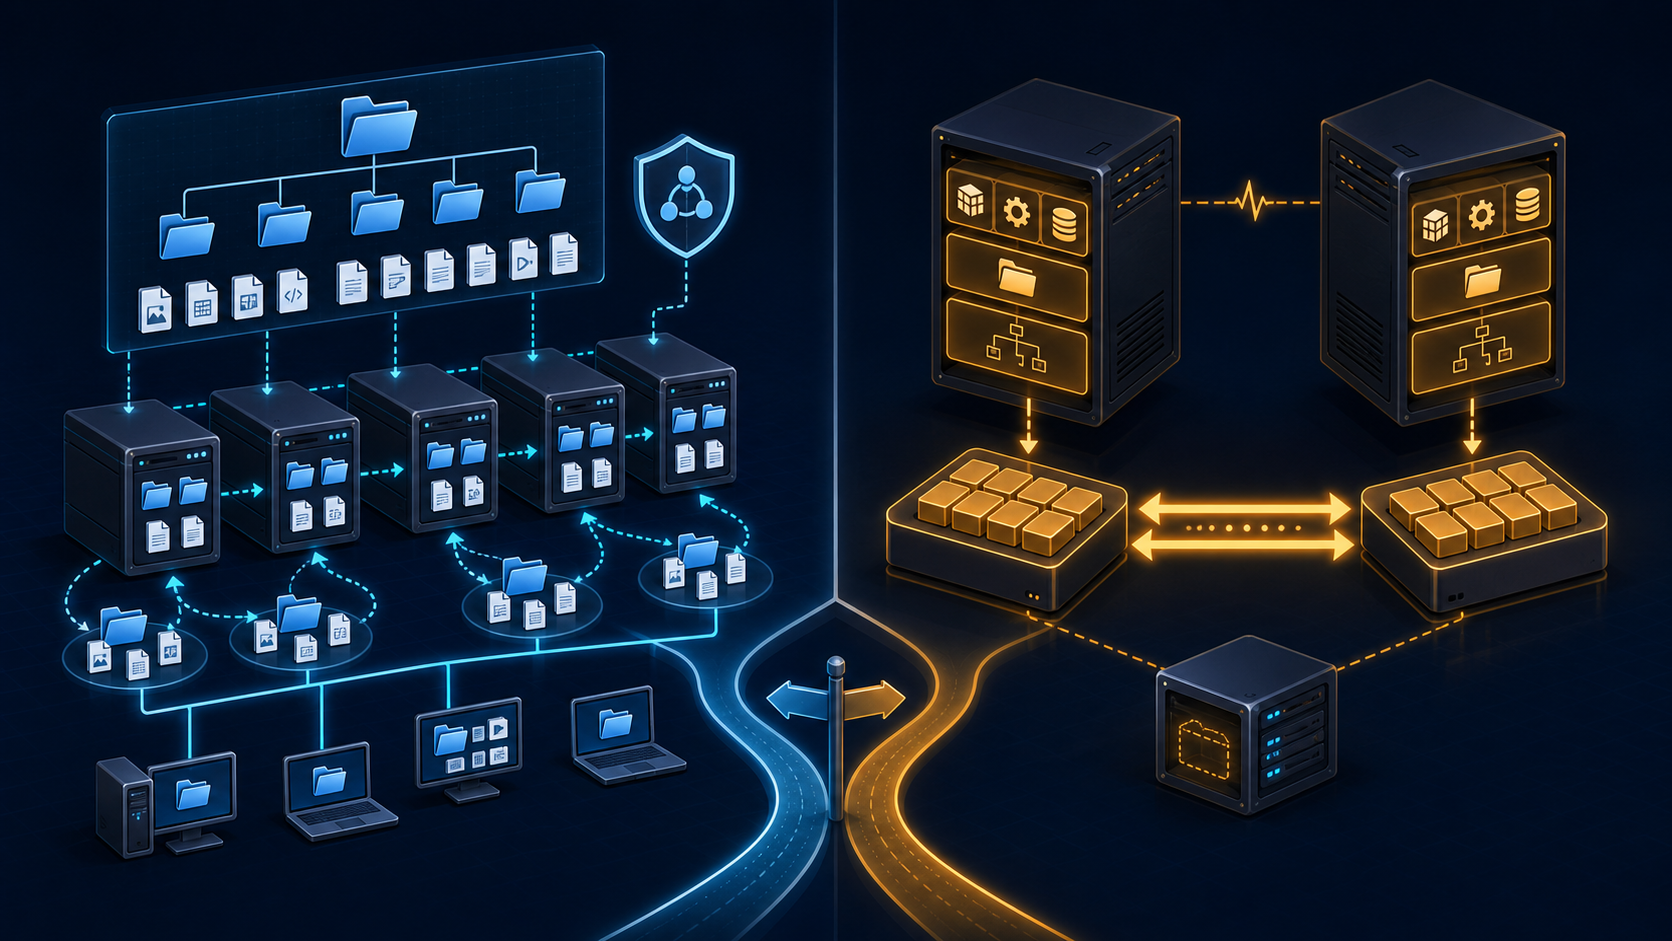
GlusterFS vs DRBD: Architecturale verschillen
| Item | GlusterFS Replica | DRBD 9 |
|---|---|---|
| Replicatielaag | Bestanden, mappen en metadata | Gewijzigde blokken van het blokapparaat |
| I/O-pad | Client/FUSE communiceert met meerdere bricks | Kernelmodule stuurt lokale blok-I/O door naar de peer |
| Bovenliggend bestandssysteem | GlusterFS biedt zelf een gedeelde naamruimte | ext4, XFS of een conditioneel clusterbestandssysteem vereist |
| Algemeen toegangsmodel | Meerdere clients koppelen gelijktijdig aan | Single-primary Active-Passive is het meest representatief |
| Schaalmethode | Replica-sets distribueren voor capaciteits- en clientschaling | DRBD 9 ondersteunt replicatie naar meerdere peers, maar is geen gedistribueerd bestandssysteem |
| Hersteleenheid | Herstel per bestand en bepaling van split-brain | Her-synchronisatie van blokken op basis van een dirty bitmap |
Het onderscheid in één zin
- Als meerdere servers tegelijkertijd dezelfde bestandsstructuur moeten lezen en schrijven, overweeg dan de gedeelde bestandssemantiek van GlusterFS.
- Als u het lokale blokapparaat van een service wilt overdragen aan een ander knooppunt om daar verder te gaan, overweeg dan DRBD single-primary.
- In beide gevallen is replicatie geen back-up; verwijderingen, ransomware en logische fouten kunnen ook worden gerepliceerd.
GlusterFS vs DRBD: schrijfvoltooiing en latentie
Een GlusterFS replica-volume laat de client bestandsbewerkingen doorsturen naar de bricks van de replica-set via de AFR-laag. Na een storing kan herstel (heal) nodig zijn, en als hetzelfde bestand in verschillende partities wordt gewijzigd, kan er een split-brain ontstaan waarbij niet automatisch kan worden bepaald welke kopie de juiste is. Het louter verhogen van het aantal replica’s maakt het quorumbeleid niet automatisch compleet.
Protocol C van DRBD is synchrone replicatie waarbij de voltooiing pas aan de bovenliggende laag wordt geretourneerd nadat zowel de lokale als de externe schijfschrijfactie is bevestigd. In plaats van de RPO voor verlies van een enkel knooppunt te verkleinen, worden de round-trip latentie en de schrijfvertraging van beide opslagsystemen weerspiegeld in de applicatie. Omdat de voltooiingscriteria voor Protocol A en B verschillen, mag u niet op basis van de naam alleen concluderen dat ‘DRBD altijd synchroon is’.
Het feit dat blokken identiek zijn, betekent niet dat databasetransacties of het bestandssysteem in orde zijn. Bij stroomuitval moet u de persistentie van de cache, het bestandssysteemjournaal, het fsync-gedrag van de applicatie en het herstel na een geforceerde afsluiting afzonderlijk verifiëren.
GlusterFS vs DRBD: de precieze betekenis van gelijktijdige toegang
GlusterFS is ontworpen om volumes door meerdere clients te laten koppelen, maar de methode waarbij een applicatie de onderliggende mappen van een brick direct leest en schrijft, is geen ondersteund gedeeld toegangspad. U moet het Gluster-clientprotocol gebruiken om de consistentie en de heal-metadata van AFR te behouden.
Bij DRBD single-primary is een configuratie waarbij een standaard bestandssysteem zoals ext4 of XFS slechts op één Primary wordt gekoppeld, de standaard. DRBD ondersteunt ook dual-primary, maar voor gelijktijdige koppeling zijn een gedistribueerd bestandssysteem op basis van lock-mechanismen zoals GFS2 of OCFS2 en fencing vereist. Als u een standaard XFS-bestandssysteem op twee knooppunten tegelijk koppelt, kan het bestandssysteem beschadigd raken.
GlusterFS vs DRBD: quorum en split-brain
Een replica 2-configuratie kan bij een netwerkpartitie niet tegelijkertijd de consistentie en de beschikbaarheid maximaliseren. De officiële documentatie van Gluster beschrijft replica 3 of een arbiter-volume en client-quorum als manieren om het risico op split-brain te verkleinen. Een arbiter is geen derde kopie van de volledige data, maar fungeert als een stemgerechtigde die metadata gebruikt om te bepalen welke kant de juiste is.
Controle van de alleen-lezen status van GlusterFS
sudo gluster peer status
sudo gluster volume list
sudo gluster volume info <VOLNAME>
sudo gluster volume status <VOLNAME> detail
Lijst met heal- en split-brain-items controleren
sudo gluster volume heal <VOLNAME> info summary
sudo gluster volume heal <VOLNAME> info
sudo gluster volume heal <VOLNAME> info split-brain
Bij het oplossen van een split-brain kan het selecteren van de source brick op basis van alleen grootte of de meest recente tijd leiden tot het overschrijven van correcte gegevens. Bepaal samen met de applicatie-eigenaar wat de juiste versie is, zorg voor een back-up en pas daarna de herstelprocedure per bestand toe.
Huidige opties met betrekking tot quorum controleren
sudo gluster volume get <VOLNAME> cluster.quorum-type
sudo gluster volume get <VOLNAME> cluster.quorum-count
sudo gluster volume get <VOLNAME> cluster.server-quorum-type
sudo gluster volume get <VOLNAME> all | grep -Ei 'quorum|arbiter'
Rollen, protocollen en quorum in DRBD 9
Een DRBD-resource heeft een Primary- of Secondary-rol. Hoewel single-primary het gebruikelijke HA-patroon is, is DRBD 9 niet beperkt tot twee knooppunten en kan een resource naar meerdere hosts worden gerepliceerd. Echter, naarmate het aantal knooppunten toeneemt, worden de verbindingen, metadata, her-synchronisatie en het quorum-ontwerp complexer, dus moet u onderscheid maken tussen ‘ondersteund’ en ‘geschikt voor productie’.
Status van DRBD en voortgang van replicatie controleren
sudo drbdadm status
sudo drbdsetup status --statistics
cat /proc/drbd
journalctl -k -b | grep -i drbd
Dry-run voor het wijzigen van instellingen
sudo drbdadm -d adjust <RESOURCE>
sudo drbdadm dump <RESOURCE>
DRBD bevordert een overblijvende Secondary niet uit zichzelf tot Primary om de applicatie te starten. Pacemaker, DRBD Reactor of strikte handmatige procedures moeten de volgorde van het stoppen van de service, het ontkoppelen van het bestandssysteem, de rolwisseling, het koppelen en het starten van het VIP en de service beheren.
Status van quorum en rollen controleren
sudo drbdsetup status --verbose --statistics
sudo drbdadm status <RESOURCE>

# Indien Pacemaker samen wordt gebruikt
sudo crm_mon -1Arf
Als er slechts twee knooppunten zijn en de communicatie wordt verbroken, kan het netwerk alleen niet bepalen welke kant de actieve, juiste versie is. Ontwerp daarom een combinatie van diskless tiebreaker/quorum in DRBD 9, fencing/STONITH in Pacemaker en onafhankelijke stroom- en netwerkpaden.
GlusterFS vs DRBD: waarom failover verschilt
| Stap | GlusterFS | DRBD |
|---|---|---|
| Detectie van storingen | Client detecteert mislukte verbinding met brick | Detectie van peer-verbinding en wijziging in schijfstatus |
| Bepaling van schrijftoestemming | AFR client-quorum en volume-status | Rol, schijfstatus, DRBD-quorum |
| Omschakeling van het datapad | Client communiceert met de actieve brick | Clusterbeheerder voert promotie, mount en service-start uit |
| Herstel | Bestandsgebaseerde healing en bepaling van split-brain | Blok-resynchronisatie en herintegratie van rollen |
| Essentiële externe elementen | Meerdere volfile-servers in normale toestand, monitoring | Meestal clusterbeheerder en fencing |
Kortom, de padomleiding van GlusterFS en de service-failover van DRBD zijn niet dezelfde vorm van ‘automatische omschakeling’. De eerste betreft het I/O-pad van een gedistribueerde bestandsclient, terwijl de tweede een clusteroperatie is die het bestandssysteem en de applicaties boven op het blokapparaat in de juiste volgorde verplaatst.
GlusterFS vs DRBD: Keuze per workload
De onderstaande tabel vergelijkt de technologieën op basis van hun benadering. Controleer vóór een nieuwe implementatie of er beveiligingsondersteuning beschikbaar is vanuit de GlusterFS-community of de leverancier van de distributie, en verifieer de compatibiliteit van de DRBD-kernelmodule en -utils met de host-kernel. Zelfs als de functionaliteit aan de eisen voldoet, moet de oplossing worden uitgesloten als er geen onderhoudbaar pakketleveringskanaal beschikbaar is.
| Vereisten | Eerste overweging | Redenen voor besluit en aandachtspunten |
|---|---|---|
| Meerdere webnodes delen dezelfde geüploade bestanden | GlusterFS | Geschikt voor gelijktijdige bestandstoegang, maar valideer de prestaties bij kleine bestanden en het healing-proces |
| Active-Passive voor een enkele database die een lokaal bestandssysteem gebruikt | DRBD | Evalueer Protocol C en de clusterbeheerder, en vergelijk dit ook met database-eigen replicatie |
| Horizontaal schaalbare objectopslag | Beide opnieuw evalueren | S3-compatibele objectopslag kan geschikter zijn voor de beoogde toegang |
| Live migratie van VM’s | Voorwaardelijk DRBD | Vereist dual-primary, cluster-FS, fencing of specifieke virtualisatie-integratie |
| Grootschalige distributie van alleen-lezen bestanden | GlusterFS of objectopslag | Vergelijk ook cache, CDN en distributiepijplijnen |
| Back-up en langetermijnarchivering | Beide zijn op zichzelf onvoldoende | Vereist een aparte back-up met versiebeheer, onveranderlijkheid en off-site herstel |
Vragen om te beantwoorden vóór de keuze
- Moeten meerdere nodes tegelijkertijd hetzelfde bestandssysteem gebruiken, of is het voldoende als slechts één node dit doet?
- Wat zijn de acceptabele RPO en RTO, en is de latentie van synchrone replicatie acceptabel?
- Wat krijgt de prioriteit bij een netwerkpartitie: beschikbaarheid of consistentie?
- Is er een onafhankelijk derde stempad beschikbaar voor quorum en fencing?
- Zijn de prestaties gemeten voor normale replicatie, degraded writes en resynchronisatie?
- Is er een onafhankelijke back-up en een daadwerkelijke hersteltest voor bescherming tegen verwijdering, corruptie en ransomware?
Checklist voor operationeel beheer
- Scheid de replicatieverbinding van het serviceverkeer en monitor latentie, pakketverlies en bandbreedte.
- Test het gedrag van de service niet alleen in de normale status, maar ook tijdens het uitvallen van een node, linkonderbrekingen, herstarts en resynchronisatie.
- Stel waarschuwingen in voor de heal-backlog en split-brain bij GlusterFS, en voor de status van role, disk, connection en quorum bij DRBD.
- Verwijder force-procedures waarmee operators willekeurig beide kanten schrijfbaar kunnen maken uit het standaard runbook.
- Beheer naast replicatie ook onveranderlijke off-site back-ups met een bewaartermijn en valideer het herstel regelmatig.
Officiële documentatie en relevante handleidingen
- Officiële documentatie voor het configureren van GlusterFS-volumes
- Officiële documentatie voor GlusterFS heal en split-brain
- Officiële documentatie voor GlusterFS arbiter en quorum
- Officiële DRBD 9 gebruikershandleiding
- Handleiding voor het opzetten van GlusterFS
- Handleiding voor het opzetten van DRBD en Pacemaker
Conclusie
GlusterFS vs DRBD: De kern van de keuze ligt niet in de productnaam, maar in de benodigde toegangsmethode tussen het delen van bestanden en block-failover. GlusterFS biedt een gedistribueerde namespace op bestandsniveau en heal-functionaliteit, terwijl DRBD block-replicatie en expliciete rolwisselingen biedt. In beide gevallen moet het ontwerp gebaseerd zijn op een volledig faalmodel, inclusief quorum, fencing, observatie en onafhankelijke back-ups, om het doel van hoge beschikbaarheid te bereiken.